2026-09-17
融合 SwiGLU:速度打平,张量从四个变两个
第九个 kernel:融合的 SwiGLU MLP,transformer block 里我还没写过的最后一块。一个 SwiGLU MLP 会造出三个 [rows, intermediate] 的张量——两次投影得到的 g 和 u,然后是 h = silu(g) * u——而 intermediate 是 hidden 的 3 到 4 倍,所以这个 block 的显存就停在那里。这里融合了两件事。逐元素的 silu 和乘法合成一个 Triton kernel。以及 h 根本不再被保存:eager 之所以让它活着,是因为下投影算权重梯度时需要它,所以这一版把那次投影折进同一个 autograd 节点,让 h 在前向里就死掉,反向时再从 g 和 u 重算出来。
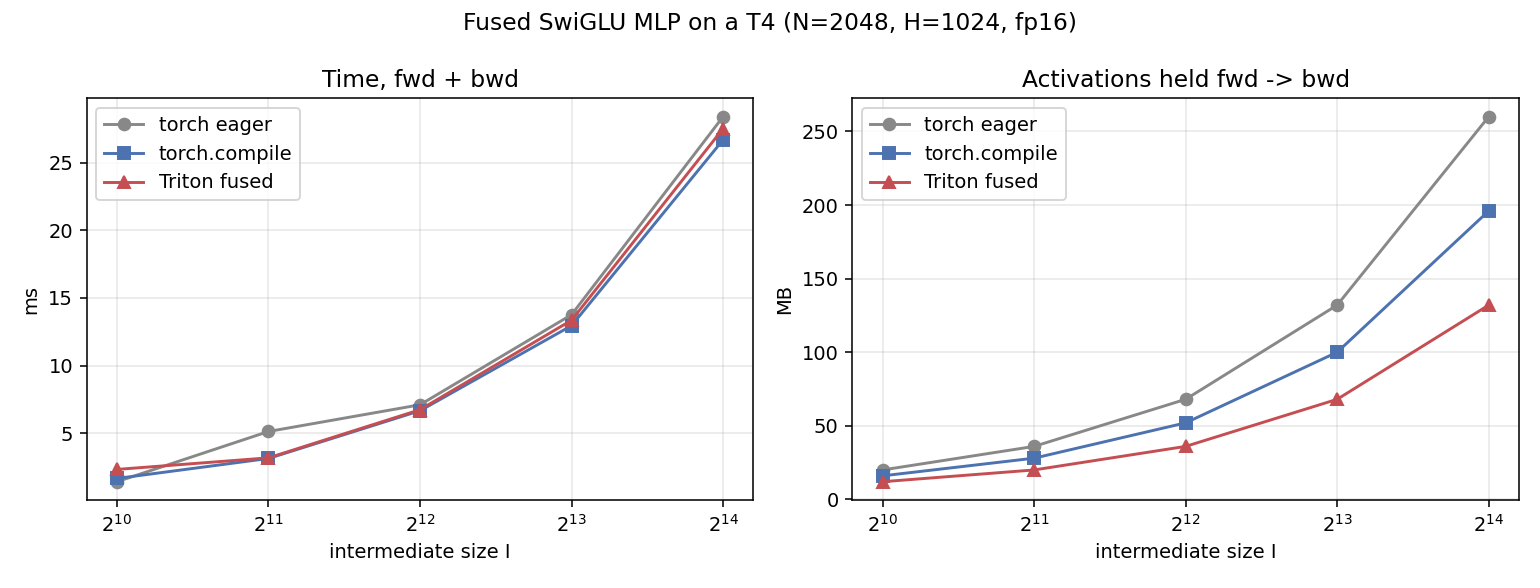
对上 torch.compile,时间是平手——intermediate 为 16384 时是 27.50ms 对 26.68ms,在 2048 以上的每一个规模都在 3% 以内。显存不是平手。前向到反向之间留住的量:eager 260MB,torch.compile 196MB,这一版 132MB。那正好是 [2048, 16384] 这个张量的四份、三份和两份,再加上输入。整步峰值是 420 / 356 / 292MB。
而这才是真正的发现。torch.compile 把融合做掉了——它把 silu 折进乘法,把 eager 的四个保存张量降到三个,一行代码,免费,逐元素这块我是赢不过它的。它不会做的,是决定把一个激活扔掉、再花代价重建它。那个决定需要知道 h 可以从已经保存的东西里便宜地重算出来,而且它改的是 autograd 图的形状,不是 kernel。这周赢的地方不是 kernel,是 autograd 节点的边界划在了哪里。
这也是离开 Colab 的第一周——它跑在 Modal 的 T4 上,同一张卡,所以数字仍然和第 1 到 8 周对得上。这样一来下一个就很明显了:flash attention 从第 3 周起就一直没写完,只有前向,而且比 torch 慢 25 倍,因为 T4 是 Ampere 之前的卡,没有 cp.async 可以做流水。而 Modal 按分钟出租 Ampere。