← 返回博客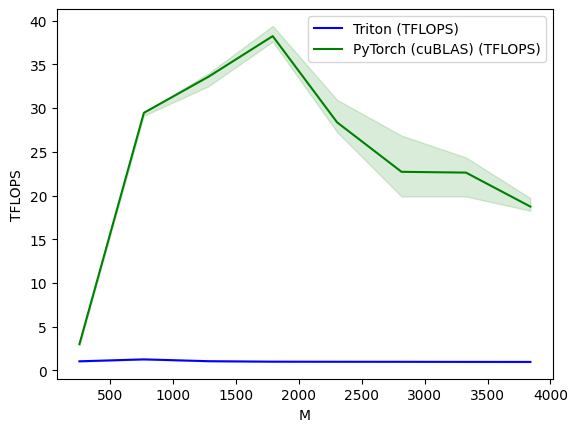
2026-08-09
矩阵乘:正确,但没用上 Tensor Core
第四个 kernel:分块矩阵乘。结果正确(在 fp16 容差内与 torch.matmul 一致),但不管矩阵多大都平在约 1 TFLOPS,而 PyTorch 的 cuBLAS 能爬到约 38 TFLOPS。
「多大都一样平」正是计算受限 kernel 的典型症状——有东西没被启用。试过更深的流水线(num_stages),试过把边界掩码去掉,都纹丝不动。直接 grep 了编译出来的 PTX:没有任何 mma.sync、HMMA 或 wmma 指令。Tensor core 一次都没被触发。
和 flash attention 不同,这一次不是硬性的架构墙——Turing 是有 tensor core 的。更像是当前的 Triton(3.6.0)已经不再为 T4 的 sm_75 目标生成 tensor core 代码了,因为项目的重心已经转向更新的硬件。连续第二周用老 T4,实实在在地暴露出当前 Triton 面向的硬件、和 Colab 免费档 GPU 实际能做的事之间的差距。