← 返回博客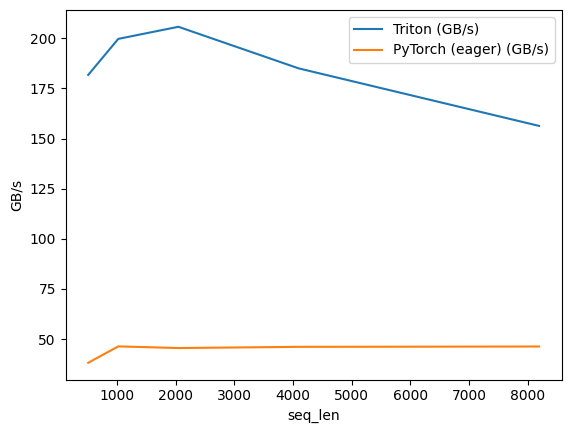
2026-08-23
RoPE:一个 kernel 管两个方向
第六个 kernel:RoPE(旋转位置编码),前向加反向。和上周的 RMSNorm 是同一条论文线索——还在读 Kimi K3 的报告,RoPE 是它注意力栈里另一块值得动手写、而不是读过去就算了的部分。用的是 Llama 那种「rotate-half」约定——把 head_dim 对半切开,让两半互相旋转——而不是 GPT-J 的交错配对版本,因为现在大多数 LLM(包括 Kimi K3)用的都是前者。
两个方向都正确:前向最大差值 0.00390625,反向最大差值 0.00390625,都是正常的 fp16 舍入。吞吐:在序列长度 512–8192 上,Triton 约 156–206 GB/s,PyTorch eager 平在约 38–46 GB/s。不过和 softmax、RMSNorm 一样要加个限定——那是融合 kernel 对未融合的 eager 基线,不是融合对融合,所以我不把它算作一次干净的胜利。
真正有意思的地方是:反向不需要第二个 kernel。旋转 -theta 正好抵消旋转 theta,所以反向就是把前向那个 kernel 再调一次,用一个 NEGATE_SIN 标志在编译期把 sin 变成 -sin。不用另外推一遍梯度,也不用再写一套指针运算。
下一个大概是交叉熵损失的前向和反向——它是每一步训练都会碰到的那个算子,而且能把 RMSNorm 和 RoPE 补成一个看起来真像 transformer 前向的东西。