← 返回博客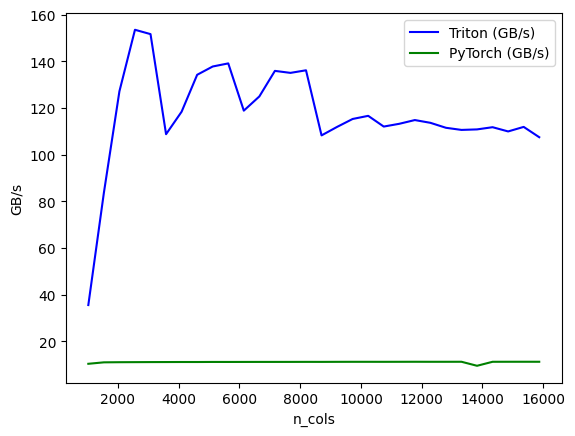
2026-08-16
RMSNorm:前向、反向,以及它为什么重要
第五个 kernel:RMSNorm,前向加反向。动机来自这条线的论文那一半——最近在读 Kimi K3 的报告,RMSNorm 反复作为报告里比较大的架构收益出现,就紧挨着注意力残差。感觉与其只是读到,不如动手写一遍。
前向:正确(最大差值 0.00195,属于正常的 fp16 容差),约 230 GB/s,对比未融合的 PyTorch 基线约 20 GB/s。和几周前 softmax 那次是同一个融合故事。
反向是更难的一半——得真的把梯度推出来(dx = rrms * (dxnorm - x_norm * mean(dxnorm * x_norm))),而且权重梯度需要跨每一行求和,不只是行内。这里用了 atomic_add,能跑通(dx 差值 0.0078,dweight 差值 0.0625,考虑到 dweight 的数值尺度更大,两个都没问题),但它的吞吐曲线是锯齿状的,不像前向那条那么干净——是真实的原子操作争用,不是 bug。不管怎么说,都还是比 PyTorch 快约 10 倍。
下一步:要么用一个正经的两阶段归约把原子操作修掉,要么直接进第 6 周。