2026-09-10
融合 Linear + CE:显存少 10 倍,而且更慢
第八个 kernel:融合 linear + cross-entropy。上周那版仍然把 [batch, vocab] 的 logits 当输入,然后发现正是这个张量主导了时间和显存。所以这一版把 lm_head 投影拉进损失里:投影一块行,把它变成损失和梯度,折进 dx 和 dw,然后释放。完整的 logits 张量从不存在。反向必须在前向期间就跑——一块一旦释放,不重做那次矩阵乘就再也拿不回来。
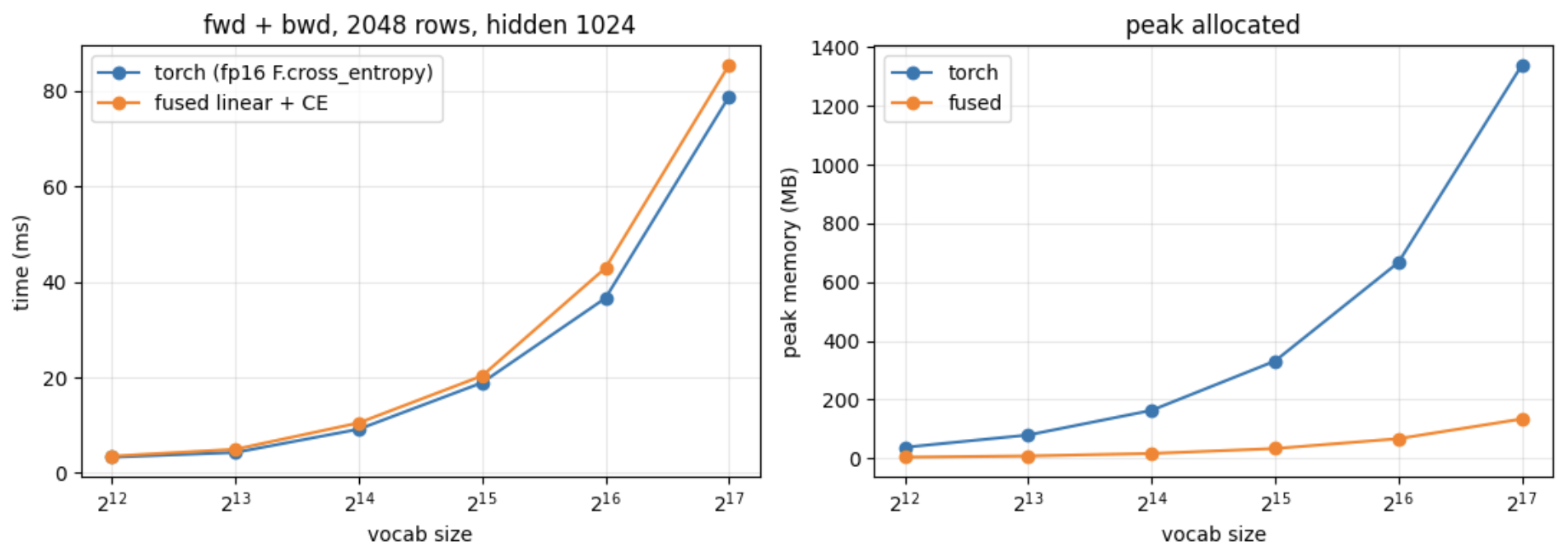
激活显存降了约 10 倍,从 vocab 4096 一路到 131072 都成立。它同时在每一个规模上都更慢,0.85–0.94 倍——而且把 chunk size 设成 2048(也就是只有一块、等于完全不分块)时仍然落后 9%。所以那个差距来自我的损失 kernel 和那些缩放梯度的 pass,不是分块本身。那个 10 倍也得加个限定:权重梯度是 [vocab, hidden],两个版本都要分配它,所以它在测量里被抵消掉了。把显卡实际要装下的东西全算进去,峰值是 2181MB 对 978MB,2.23 倍。
好的部分是上周那个下溢的下场。第 7 周把 (softmax - onehot)/n_valid 写进 fp16 缓冲区,74.3% 的值落成了恰好的零。这个 kernel 存的是纯粹的 softmax - onehot,取值在 [-1, 1] 之间,那个 1/n_valid 之后再作用到 dx 和 dw 上,那时张量已经很小了。同样的数学、同样的 dtype,零占比 0%——除法只是挪到了矩阵乘的另一边。
下一个大概是融合的 SwiGLU MLP。RMSNorm、RoPE、注意力和损失都写完之后,它是 transformer block 里我还没写过的最后一块,也是这个 block 另一个存放大激活张量的地方。