2026-08-30
交叉熵:差点把我骗过去的那次基准测试
第七个 kernel:交叉熵损失,前向和反向融进同一个 kernel。梯度就是 softmax(logits) - onehot(target),除了 logits 什么都不依赖——所以可以在前向时就算出来,直接写回输入缓冲区。PyTorch 必须再为梯度分配一个 [batch, vocab] 张量。这个不用。
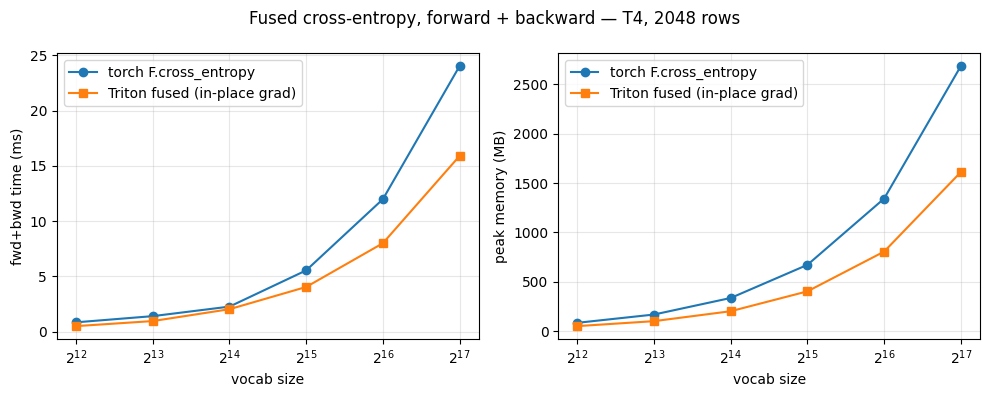
第一组数字是快 2.5 倍、省 2.5 倍显存,我差点就到此为止了。我的基线是 F.cross_entropy(x.float(), targets),而那个 .float() 悄悄给 logits 做了一份完整的 fp32 拷贝,这笔开销我的 kernel 根本不付。换成诚实的 fp16 基线后,在 vocab 131072 下是快 1.51 倍(15.9ms 对 24.0ms)、峰值显存少 1.67 倍——而且在每个 vocab 规模下都恰好是 1.67 倍,因为 PyTorch 在前向加反向期间要让五份 logits 同时活着,而这个只要三份。这个坑值得抓,因为 F.cross_entropy 本身就是个真正的融合 kernel:这是我第一周不再拿未融合的 eager PyTorch 当对照。
代价在这里:vocab 32k 时,它写出去的梯度值有 74.3% 恰好是零。每个值大约是 1/(vocab x batch) ≈ 6e-8,而 fp16 最小的次正规数是 5.96e-8,所以尾部在写进缓冲区的路上就下溢了。GradScaler 也救不了——那个缩放是在 backward() 里才到的,那时 kernel 早就把它们存完了。
下一个大概是融合的 linear + cross-entropy——把 lm_head 投影分块折进损失里,让 [batch, vocab] 的 logits 根本不存在。