← 返回博客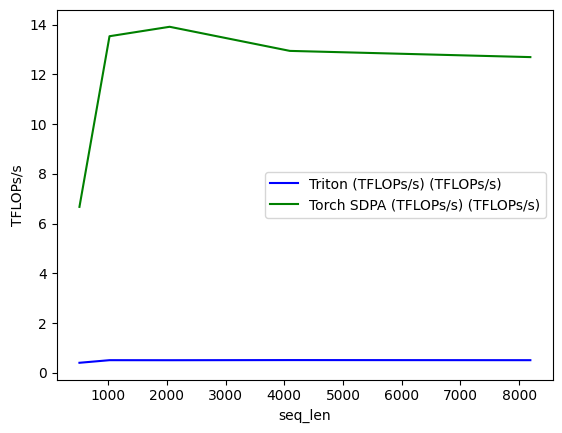
2026-08-03
Flash Attention:正确,但不快
第三个 kernel:flash attention。正确性很稳(与 PyTorch 的最大差值 0.000122),但在我的 T4 上慢了约 25 倍。
以为是计算受限,试了 exp2 的技巧——没有变化。T4(Turing)缺少 flash attention 需要的流水线硬件。是硬件上限,不是 bug。
2026-08-03
第三个 kernel:flash attention。正确性很稳(与 PyTorch 的最大差值 0.000122),但在我的 T4 上慢了约 25 倍。
以为是计算受限,试了 exp2 的技巧——没有变化。T4(Turing)缺少 flash attention 需要的流水线硬件。是硬件上限,不是 bug。